LLM Workbench: RAG-чанкинг, стоимость API и поиск секретов
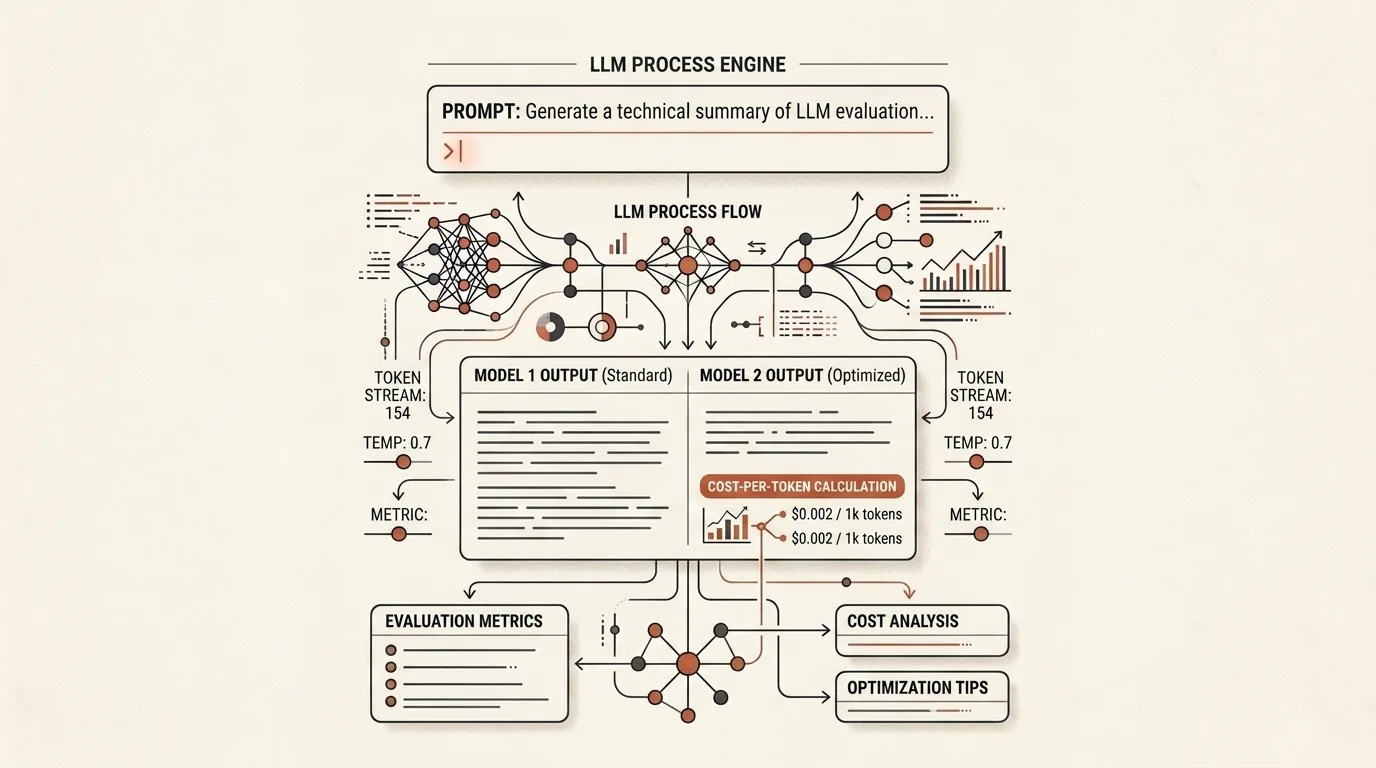
Запуск фичи на LLM приносит три проблемы, которых не видно на демо. Документы не влезают в контекстное окно, поэтому их нужно резать на чанки прежде, чем они попадут в векторную базу. Счёт за API выглядит нормально на тестах и становится непредсказуемым в масштабе, потому что никто не посчитал хостинг, на котором всё это крутится. А промпт, скопированный из баг-репорта или тикета поддержки, имеет обыкновение нести с собой учётные данные, которые никто не собирался никуда отправлять.
Разбиение документа для retrieval
Векторная база индексирует чанки текста, а не документы целиком, поэтому первое реальное решение в RAG-пайплайне — как разрезать документ, не разрезав вместе с ним смысл.
RAG Text Chunker режет по выбранному разделителю — пустой строке, одиночному переносу или границе предложения — и переходит к резке по произвольному символу только тогда, когда ничего безопаснее не осталось. Кусок, который всё равно приходится резать точно по лимиту размера, сначала обрезается по ближайшей границе предложения, потом по ближайшему пробелу, потом по Unicode-границе слова для языков вообще без пробелов. Этот порядок важен: граница чанка, попавшая внутрь слова или посреди предложения, портит именно то семантическое сравнение, ради которого RAG вообще существует.
Overlap переносит контекст через эту границу. Вместо того чтобы начинать следующий чанк с нуля, инструмент добавляет в начало хвост предыдущего чанка — тоже обрезанный по границе предложения или слова, а не по произвольному числу символов, — так что факт, разрезанный между двумя чанками, всё ещё может найтись тем запросом, с которым совпадёт любой из них.
Счётчик токенов рядом с каждым чанком намеренно помечен как estimated: это эвристика «символы ÷ 4», а не настоящий токенайзер конкретной модели. Этого достаточно, чтобы прикинуть, влезает ли чанк в примерный бюджет; для того, чтобы по нему выставлять счёт, нужна следующая вкладка.
Честный расчёт стоимости вызова
Token & Cost Estimator делает одну вещь и прямо об этом говорит: умножает переданное вами число токенов на опубликованный тариф модели. Он не токенизирует ваш текст и не обращается к OpenAI, Anthropic или Google — плашка «Live price registry» показывает, взяты ли текущие цены из собственного JSON-фида сайта или из небольшого встроенного резерва, а у каждой строки есть ссылка на страницу цен провайдера с напоминанием её проверить: опубликованные тарифы меняются без предупреждения, и устаревшее число в таблице — самый тихий способ испортить бюджет.
Этот калькулятор питает вторую, легко забываемую цифру — хостинг. Стоимость LLM за вызов, умноженная на число активных пользователей в месяц, — это то место, где большинство прикидок стоимости останавливается, но реальный деплой ещё платит за объектное хранилище, egress-трафик и то, что вообще обслуживает запрос. Поэтому раздел Monthly Cost Projection добавляет тарифы AWS S3, Cloudflare R2, Vercel и Cloudflare Workers, каждый посчитанный ровно так, как считает сам провайдер (у S3 отдельно storage/PUT/GET/egress сверх бесплатного лимита, у Vercel — включённая полоса пропускания и последующий overage и так далее), с той же цифрой MAU на входе.
Ловим секрет до того, как он покинул вкладку
PII & Secrets Sanitizer сканирует вставленный промпт на формы, в которых реально выглядят утёкшие учётные данные: sk-proj-… и другие префиксы ключей OpenAI, ключи доступа AWS, токены GitHub, токены ботов Slack, секретные ключи Stripe, а также email-адреса, телефоны и цифровые группы в форме SSN. Всё найденное маскируется в выводе и подсчитывается, так что промпт, на вид чистый, показывает, что он на самом деле нёс.
Это эвристическое сканирование по паттернам, а не аудит безопасности, и страница говорит об этом ещё до того, как вы что-то вставите. Найденный здесь секрет нужно ротировать вне зависимости от того, что будет дальше — инструмент, который его нашёл, не делает его безопасным, он делает его видимым.
Ничего не покидает браузер
Чанкинг, расчёт стоимости и поиск паттернов работают целиком в памяти страницы. Единственный сетевой запрос, который страница делает сама, — загрузка публичного JSON-реестра цен: текст документа, число токенов и содержимое промпта в этот запрос никогда не попадают.
Похожие инструменты


Частые вопросы
RAG Text Chunker использует настоящий токенайзер?
Нет — счётчик токенов у чанков — это оценка по эвристике «символы ÷ 4», а не точный токенайзер конкретной модели. Этого достаточно, чтобы прикинуть чанк под примерный бюджет контекста; для реальной стоимости вызова используйте токенайзер провайдера или число токенов из самого ответа API.
Как чанкер решает, где резать текст?
Он старается не резать посреди слова или предложения. Разбиение сначала идёт по выбранному разделителю (абзац, строка или предложение), а любой кусок длиннее лимита обрезается сначала по ближайшей границе предложения, потом по ближайшему пробелу, потом по Unicode-границе слова для языков без пробелов вообще — резка по произвольному символу происходит только в самом крайнем случае.
Откуда берутся цены на модели и хостинг?
Из версионированного JSON-реестра на этом сайте, с встроенным резервным набором на случай, если живой запрос не прошёл. У каждой записи есть дата последней проверки и source_url на страницу цен самого провайдера — инструмент показывает эту дату и напоминает свериться перед бюджетированием, потому что цены провайдеров меняются без предупреждения.
Калькулятор стоимости реально обращается к OpenAI, Anthropic или Google?
Нет. Вы вводите число входных и выходных токенов — из оценки RAG Chunker, своего токенайзера или реального ответа API — а инструмент умножает их на опубликованный тариф выбранной модели. Это калькулятор по прайс-листу, а не живой клиент API.
Что реально ловит PII & Secrets Sanitizer?
Учётные данные с узнаваемой формой: ключи OpenAI, ключи доступа AWS, токены GitHub, токены ботов Slack, секретные ключи Stripe, email-адреса, телефоны и цифровые группы в форме SSN. Это эвристическое сканирование по паттернам, а не аудит безопасности — любой найденный здесь секрет нужно считать скомпрометированным и ротировать вне зависимости от результата.
Что-то уходит на сервер?
Текст документа, токены и содержимое промпта никогда не покидают браузер. Единственный сетевой запрос страницы — загрузка публичного JSON-реестра цен, в котором нет пользовательских данных.