Оптимизация сайта для ИИ-краулеров: Robots.txt и JSON-LD
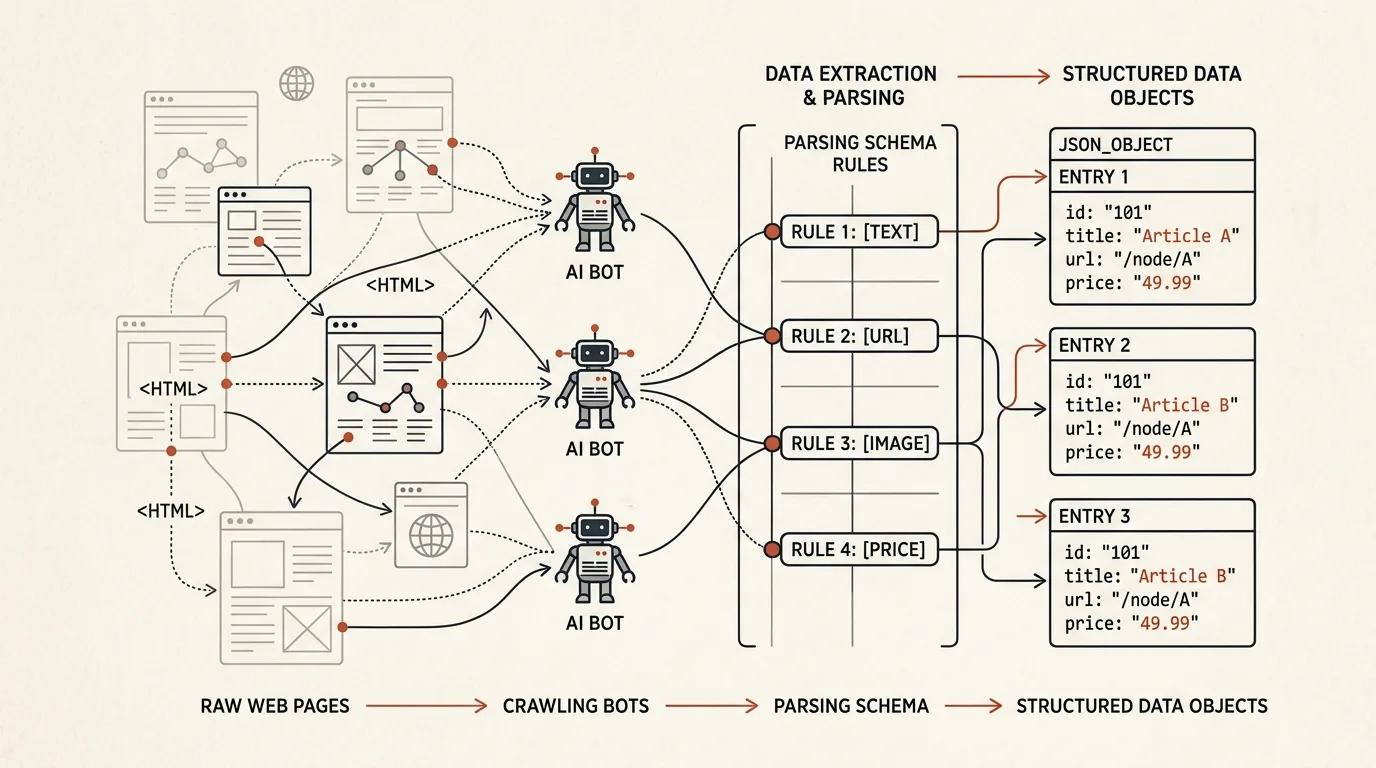
Сфера веб-краулинга изменилась навсегда. На серверы больше не заходят только привычные Googlebot, YandexBot или Bingbot. Сегодня логи веб-серверов переполнены запросами от GPTBot (OpenAI), ClaudeBot (Anthropic), PerplexityBot и OAI-SearchBot (ИИ-поиск от OpenAI).
Поскольку эти модели сканируют сеть в реальном времени, чтобы отвечать на вопросы пользователей, техническая инфраструктура вашего сайта должна быть готова к приёму таких ботов: разрешать индексацию контента, передавать точные семантические данные и закрывать доступ к приватным API.
В этой статье мы настроим файл robots.txt для ИИ-агентов, разработаем связанную структуру микроразметки JSON-LD и разберем проблемы рендеринга JS при парсинге.
1. Конфигурация Robots.txt для ИИ-краулеров
ИИ-боты должны быть выделены в отдельные директивы. Вы хотите открыть им доступ к статьям блога и страницам услуг для получения рекомендаций, но обязаны заблокировать сканирование личных кабинетов, админки и роутов авторизации.
Пример файла robots.txt для продакшена:
# Общие правила для стандартных поисковиков
User-agent: *
Allow: /
Disallow: /admin/
Disallow: /api/
Disallow: /checkout/

# Правила для OpenAI ChatGPT (сбор материалов для ответов)
User-agent: GPTBot
Allow: /
Disallow: /admin/
Disallow: /api/
Disallow: /checkout/
Disallow: /private/

# Правила для OpenAI Search (поиск в реальном времени)
User-agent: OAI-SearchBot
Allow: /
Disallow: /admin/
Disallow: /api/

# Правила для Anthropic Claude
User-agent: ClaudeBot
Allow: /
Disallow: /admin/
Disallow: /api/

# Правила для Perplexity Search
User-agent: PerplexityBot
Allow: /
Disallow: /admin/
Disallow: /api/

# Блокируем агрессивных ботов, которые обучаются на данных без отдачи трафика
User-agent: CCBot
Disallow: /
User-agent: Amazonbot
Disallow: /
2. Разработка связанных графов JSON-LD Schema
Большие языковые модели считывают информацию не так, как люди — они строят связи между именованными сущностями. Если вы опишете цены и услуги обычным текстом, ИИ может ошибиться при интерпретации.
Внедрение структурированного JSON-LD (JSON Linked Data) в шапку страниц гарантирует точную передачу фактов.
Пример связанного графа для организации и оказываемой ею услуги разработки SaaS:
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Organization",
      "@id": "https://alexrel.com/#organization",
      "name": "Разработка Алекса Рела",
      "url": "https://alexrel.com",
      "logo": "https://alexrel.com/logo.png",
      "sameAs": [
        "https://github.com/alexrel",
        "https://linkedin.com/in/alexrel",
        "https://x.com/_alexrel"
      ]
    },
    {
      "@type": "Service",
      "@id": "https://alexrel.com/ru/saas-development#service",
      "name": "Архитектура и разработка B2B SaaS под ключ",
      "description": "Разработка многопользовательских платформ от структуры БД до биллинга Stripe и RAG-ботов поддержки.",
      "provider": {
        "@id": "https://alexrel.com/#organization"
      },
      "areaServed": "Worldwide",
      "offers": {
        "@type": "Offer",
        "priceCurrency": "USD",
        "price": "5000",
        "priceSpecification": {
          "@type": "UnitPriceSpecification",
          "priceType": "https://schema.org/MinimumPrice",
          "price": "5000",
          "priceCurrency": "USD"
        }
      }
    }
  ]
}
3. Решение проблем клиентского рендеринга (CSR) для ИИ
Классический поисковик Googlebot выделяет гигантские мощности для рендеринга JavaScript. Однако большинство ИИ-краулеров оптимизируют скорость и скачивают только чистый, необработанный HTML-код.
Если ваше приложение использует Client-Side Rendering (например, собранный React или Vue проект без бэкенда с пустым <div id="app"></div>), ИИ увидит пустую страницу и не сможет прочитать информацию о вас.
Решение для проектов на Nuxt 3:
- Включите Server-Side Rendering (SSR): Убедитесь, что параметр
ssr: trueактивирован вnuxt.config.ts. - Настройте пререндеринг для статических страниц: Сгенерируйте HTML-файлы заранее на этапе сборки:
// nuxt.config.ts
export default defineNuxtConfig({
  routeRules: {
    '/': { prerender: true },
    '/saas-development': { prerender: true },
    '/telegram-bots': { prerender: true },
    '/geo-seo': { prerender: true },
    '/consultations': { prerender: true }
  }
});
Это гарантирует, что при обращении GPTBot или ClaudeBot к вашему серверу они мгновенно получат наполненный текстом HTML-документ.
При проектировании инфраструктуры индексации для проектов LingvoHabit и TeleGo.io мы внедрили именно такие схемы пререндеринга и вложенной разметки. Это позволило нам добиться быстрого сканирования и цитирования страниц в ИИ-поисковиках.
Источники и документация
- Документация OpenAI по краулерам — актуальные user-agent'ы GPTBot и OAI-SearchBot
- Anthropic: как работает ClaudeBot — официальные правила краулера Claude
- Schema.org — полный словарь типов структурированных данных
- Google: введение в robots.txt — синтаксис и приоритеты директив
Подготовка технического слоя для ИИ-сканирования — залог сохранения позиций вашего бизнеса на рынке поискового трафика нового поколения. Подробнее о том, как устроен этот маркетинг будущего, читайте в моей статье Generative Engine Optimization (GEO) — Новое SEO.
Если вам нужна профессиональная помощь в проектировании JSON-LD микроразметки, настройке SSR-роутинга или конфигурации robots.txt под ИИ-ботов, изучите мою страницу GEO- и SEO-продвижения под ключ или запишитесь на Консультацию.
Частые вопросы
Нужно ли пускать на сайт всех ИИ-ботов подряд?
Нет. Разделяйте ботов по назначению: поисковые и отвечающие боты (GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot) стоит пускать — они приводят цитирования и трафик. Чисто обучающие краулеры вроде CCBot можно блокировать: они собирают данные, не отдавая ничего взамен.
Увидят ли ИИ-краулеры контент моего SPA на Vue или React?
Не гарантированно. Часть ИИ-ботов не исполняет JavaScript, поэтому клиентский рендеринг для них — пустая страница. Решение — SSR или пререндеринг: сервер должен отдавать готовый HTML с текстом и разметкой.
Какая JSON-LD разметка важнее всего для ИИ-поиска?
Связанный граф @graph с Organization/Person (кто вы), Service или Product (что предлагаете) и WebPage с dateModified. Критично, чтобы разметка точно совпадала с видимым контентом — расхождение подрывает доверие к источнику.

Автор
Alex RelFullstack Engineer
В коммерческой разработке с 2011 года — больше 15 лет. Автор двух SaaS-продуктов: TeleGo.io и LingvoHabit.com. Статьи здесь выросли из реальной клиентской и продуктовой работы.