Как UUIDv7 добавил время в сортируемый UUID
UUID появился не как попытка придумать красивую строку для идентификатора, а как ответ на практическую проблему распределённых систем: разные машины должны были создавать уникальные значения самостоятельно, не обращаясь к общему серверу за следующим номером. Эта идея хорошо пережила смену платформ и протоколов, однако самая популярная версия UUIDv4 оставила базам данных неудобное наследство в виде полностью случайного порядка ключей. UUIDv7 сохраняет децентрализованную генерацию, но переносит время в начало значения, благодаря чему соседние по времени идентификаторы обычно оказываются рядом и при сортировке.
От Apollo NCS до стандарта IETF
Предшественник современного UUID появился в Network Computing System компании Apollo Computer. Объектам распределённой системы требовались идентификаторы, которые можно было выпускать на разных компьютерах без центральной координации. Позднее этот подход вошёл в Distributed Computing Environment организации Open Software Foundation, поэтому в старой документации до сих пор встречается название DCE UUID. Microsoft адаптировала тот же формат под именем GUID для COM и Windows.
В 2005 году RFC 4122 собрал распространённые варианты UUID в одном документе IETF. Первая версия сочетала время, clock sequence и 48-битное поле node, в котором мог находиться адрес сетевого интерфейса или его случайная замена. Вторая версия относилась к DCE Security, версии 3 и 5 детерминированно строились из имени и пространства имён с помощью MD5 или SHA-1, а UUIDv4 оставлял 122 бита для случайных данных. Именно v4 стал обычным выбором для публичных идентификаторов, поскольку его легко создавать и он не кодирует время или сведения об устройстве.
В мае 2024 года RFC 9562 заменил RFC 4122, уточнил прежние форматы и стандартизировал версии 6, 7 и 8. UUIDv6 переставляет поля старого UUIDv1 так, чтобы время оказалось в начале, UUIDv8 оставляет пространство для специальных схем, а UUIDv7 использует современный Unix timestamp и не наследует устройство полей v1.
Почему случайный ключ осложняет работу B-tree
Фраза «база хранит строки по первичному ключу» верна не для каждой СУБД. Например, PostgreSQL обычно хранит строки в heap-таблице, а объявление PRIMARY KEY создаёт отдельный уникальный B-tree. В InnoDB первичный ключ, напротив, служит кластерным индексом и содержит сами данные строки. Несмотря на разницу в устройстве таблиц, индекс в обоих случаях должен найти страницу, соответствующую новому ключу, и добавить туда запись.
UUIDv4 равномерно разбрасывает вставки по всему диапазону индекса. Когда индекс вырастает, это увеличивает рабочий набор страниц, ухудшает локальность обращений к кэшу и может приводить к разделению заполненных страниц. UUIDv7 направляет близкие по времени значения в соседний диапазон B-tree, поэтому вставки обычно затрагивают меньше страниц. Это полезное свойство, а не универсальная гарантия ускорения: результат зависит от СУБД, размера индекса, fill factor, накопителя и характера нагрузки. При высокой параллельности последовательные ключи также способны создать конкуренцию за правую границу индекса.
Сам по себе автоинкремент тоже не является небезопасным или плохим ключом. Он прост, компактен и хорошо подходит для одной базы данных. Проблема возникает, когда последовательное число отдают наружу и тем самым раскрывают приблизительный объём записей, либо когда идентификаторы нужно создавать независимо в нескольких узлах. В таких ситуациях UUIDv7 позволяет сохранить распределённую генерацию и получить более удобный для индекса порядок.
Как устроен UUIDv7
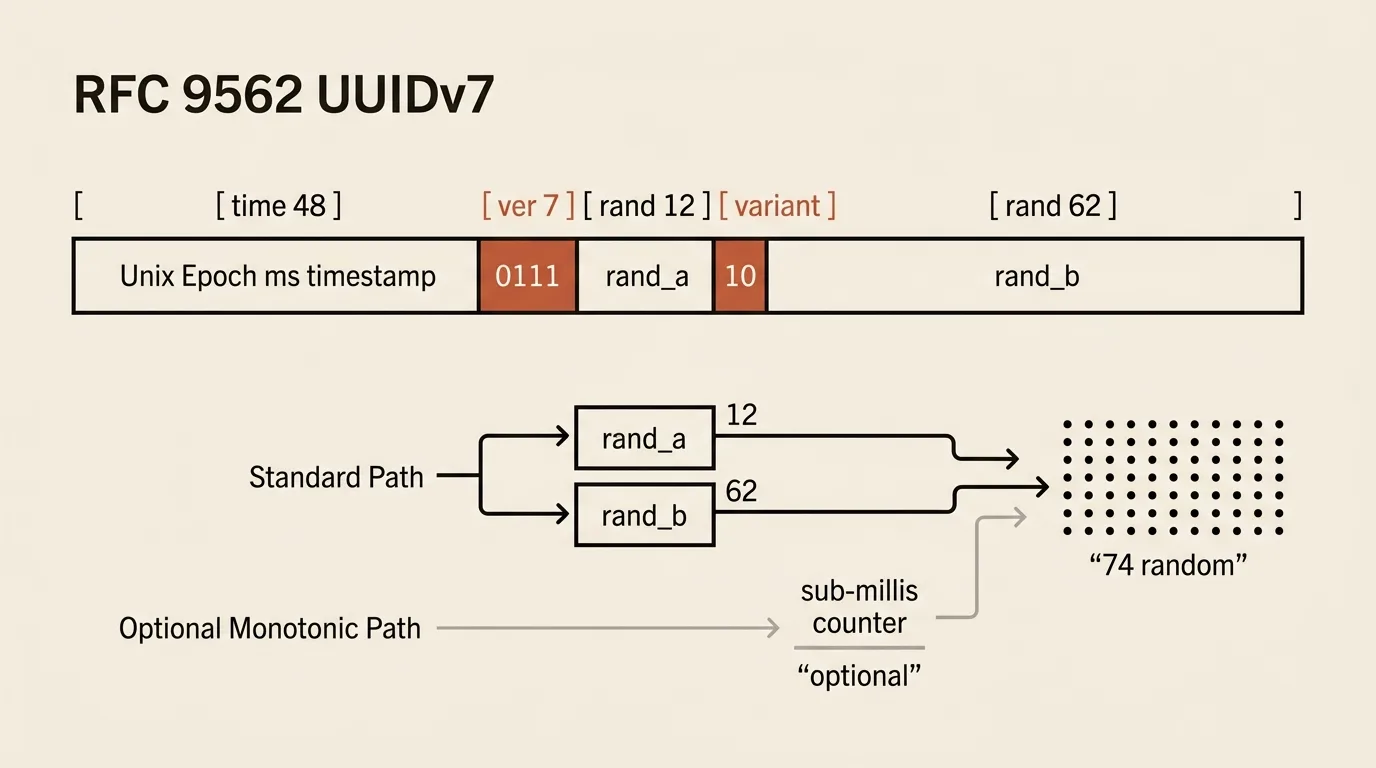
Первые 48 бит UUIDv7 содержат количество миллисекунд с начала Unix epoch. Затем идут четыре бита версии, 12 бит поля rand_a, два бита варианта и 62 бита rand_b. В обычной реализации последние два случайных поля дают в сумме 74 случайных бита. RFC также разрешает использовать часть этого пространства для дробной части миллисекунды или монотонного счётчика, но это дополнительная стратегия генератора, а не обязательная часть формата.
Поскольку timestamp занимает старшие биты, UUIDv7 из более поздней миллисекунды сравнивается как большее 128-битное значение. Это даёт удобную приблизительную хронологию, но не обещает полного порядка событий. Если несколько идентификаторов созданы в одну миллисекунду и оставшиеся биты случайны, их взаимный порядок тоже будет случайным. Перевод системных часов назад может нарушить последовательность между миллисекундами, если реализация отдельно не защищается от такого сценария.
Поддержка генерации зависит от конкретной версии СУБД. Например, PostgreSQL 18 добавил встроенную функцию uuidv7() и извлечение timestamp из UUIDv7. Если база умеет хранить тип UUID, но не умеет создавать седьмую версию, идентификатор можно сгенерировать в приложении и записать как обычное 128-битное значение. Перед выбором встроенной функции стоит проверить документацию именно той версии базы, которая работает в проекте.
Чем UUIDv7 отличается от ULID, NanoID и CUID2
Каноническая спецификация ULID также отводит первые 48 бит времени Unix в миллисекундах, а оставшиеся 80 бит случайности кодирует вместе с timestamp в 26 символов Crockford Base32. Благодаря алфавиту и расположению времени строковые ULID можно сортировать лексикографически. Базовая случайная генерация не гарантирует порядок внутри одной миллисекунды, хотя отдельный monotonic API может последовательно увеличивать случайную часть.
NanoID и CUID2 решают другую задачу. Они предлагают компактные или трудноугадываемые идентификаторы, но время в начале не является обязательным свойством этих форматов, поэтому считать их прямыми сортируемыми аналогами UUIDv7 нельзя. Выбор зависит от того, что важнее проекту: стандартный тип UUID в базе, хронологическая локальность, длина текстовой записи или совместимость с конкретной библиотекой.
Что создаёт наш генератор
UUID Generator создаёт UUIDv4, UUIDv7 и UUIDv1 с рандомизированным node вместо реального MAC-адреса. В нём также доступны ULID, NanoID и CUID2-подобный идентификатор на SHA-256, причём последняя опция является совместимым по идее форматом, а не вызовом официальной библиотеки CUID2. Для случайных данных инструмент использует crypto.getRandomValues, умеет создавать значения пакетами и менять их текстовое представление.
В UUIDv7 нашего генератора 74 свободных бита заполняются случайными данными. Дополнительного счётчика для одной миллисекунды нет, поэтому несколько значений, созданных почти одновременно, не обязаны сохранять порядок выпуска. Чтобы увидеть именно временную часть, выберите UUIDv7, создайте несколько значений с небольшой паузой и сравните их первые символы. У UUIDv4 такой закономерности не будет, поскольку timestamp в нём отсутствует.
Похожие инструменты


Частые вопросы
Чем UUIDv7 лучше UUIDv4?
UUIDv7 помещает время в старшие биты, поэтому идентификаторы из разных миллисекунд сортируются примерно в порядке создания. При использовании UUID как индексируемого ключа это обычно улучшает локальность вставок по сравнению с полностью случайным UUIDv4. Однако UUIDv7 не гарантирует строгий порядок внутри одной миллисекунды, если генератор не использует дополнительный счётчик или другую монотонную схему.
UUIDv1 всегда раскрывает MAC-адрес компьютера?
Нет. В классической схеме поле node могло содержать IEEE-адрес сетевого интерфейса, поэтому некоторые UUIDv1 действительно раскрывали сведения об устройстве. Спецификация также допускает случайный или псевдослучайный node с установленным multicast-битом. Наш генератор использует именно рандомизированный node и не читает MAC-адрес компьютера.
ULID и UUIDv7 представляют собой один формат?
Нет, хотя оба формата начинают идентификатор 48-битным временем Unix в миллисекундах. ULID кодируется 26 символами Crockford Base32 и оставляет 80 бит случайности, а UUIDv7 сохраняет стандартную 128-битную структуру UUID с полями версии и варианта. Для строгого порядка внутри одной миллисекунды обоим форматам нужна монотонная реализация.
Могут ли два случайных UUID совпасть?
Теоретически коллизия возможна. У UUIDv4 остаётся 122 случайных бита, и по приближению задачи о днях рождения вероятность хотя бы одного совпадения достигает 50% примерно после 2,7×10^18 значений. Это не отменяет требований к качественному генератору случайных чисел, но для обычных объёмов вероятность коллизии остаётся пренебрежимо малой.

Автор
Alex RelFullstack Engineer
В коммерческой разработке с 2011 года — больше 15 лет. Автор двух SaaS-продуктов: TeleGo.io и LingvoHabit.com. Статьи здесь выросли из реальной клиентской и продуктовой работы.