Как diff выбирает изменения и почему у Git несколько алгоритмов
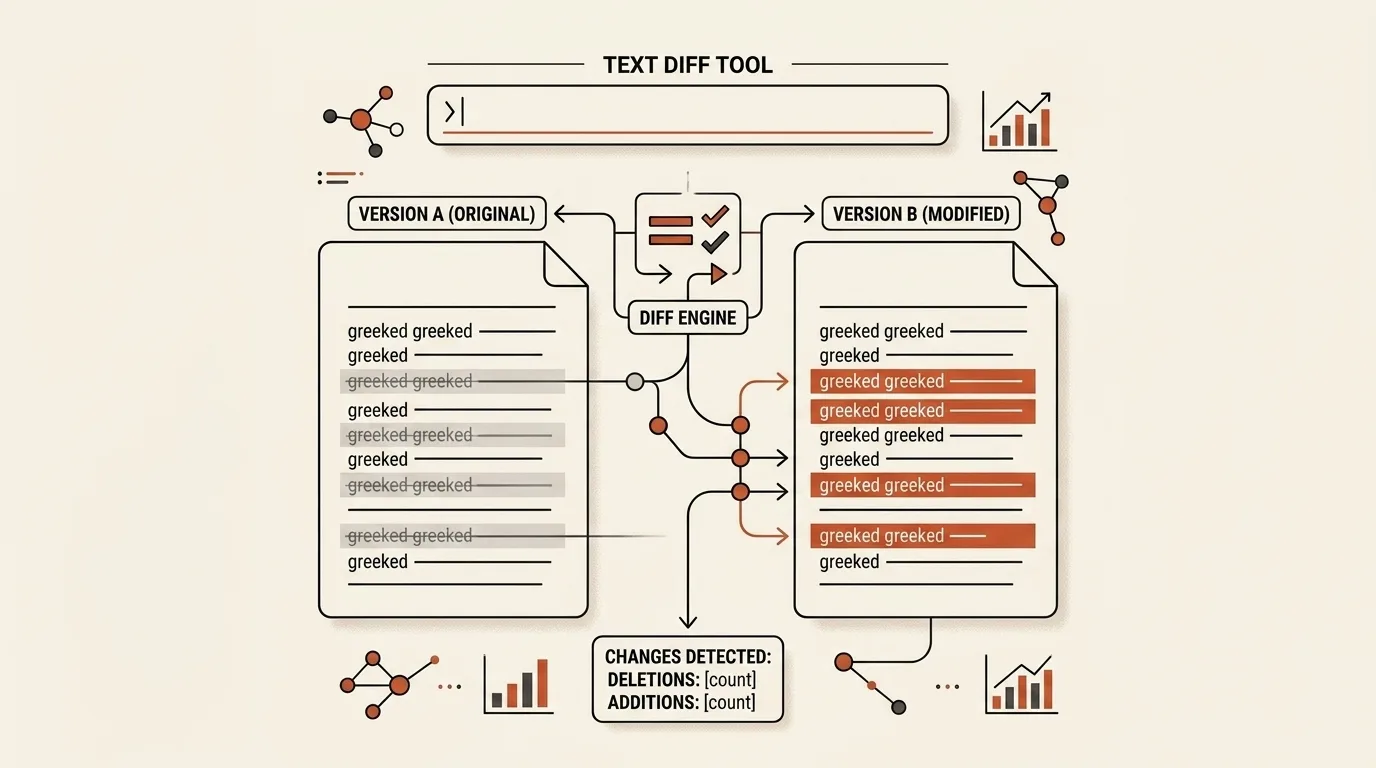
Результат diff кажется очевидным, пока в двух версиях файла не появляются повторяющиеся строки, переставленные функции или несколько одинаково подходящих мест для совпадения. Программа видит не намерение автора, а две последовательности элементов, поэтому сначала должна решить, какие элементы считать сохранившимися, а остальные представить как удаления и вставки.
У этой задачи часто бывает несколько минимальных решений. Два edit script могут содержать одинаковое число операций, но один аккуратно покажет новую функцию целиком, а другой сопоставит между собой фигурные скобки и разобьёт изменение на неудобные фрагменты. Именно поэтому история diff не закончилась после появления быстрого алгоритма: кроме размера результата важны время вычисления, память, устойчивость выравнивания и читаемость для человека.
Unix diff искал не различия, а сохраняющиеся строки
Утилита diff вошла в Fifth Edition Unix в 1974 году. В июле 1976-го Джеймс Хант и Дуглас Макилрой выпустили отчёт Bell Labs An Algorithm for Differential File Comparison, подробно описавший инженерное устройство программы. Её целью был минимальный список изменений строк, который превращает один файл в другой, однако авторов не устраивало решение, расходующее память как произведение размеров файлов.
Центральной задачей стала longest common subsequence, или LCS. Если выбрать наиболее длинную последовательность строк, встречающуюся в обоих файлах в одном порядке, эти строки можно оставить на месте, а всё остальное объяснить вставками и удалениями. Длина LCS непосредственно связана с размером кратчайшего edit script, если замену считать парой из удаления и вставки.
Алгоритм Ханта и Макилроя не заполнял простую прямоугольную таблицу динамического программирования, как утверждала прежняя версия статьи. Практическая эффективность достигалась отбором кандидатных совпадений, хешированием строк, предварительной сортировкой в классы эквивалентности и двоичным поиском. В отчёте авторы отмечали почти линейное поведение на обычных версиях документов и произведение длин файлов в худшем случае. Повторяющиеся строки создавали особенно много возможных соответствий и оставались трудным входом.
Майерс связал LCS с кратчайшим путём
В 1986 году Юджин Майерс опубликовал статью An O(ND) Difference Algorithm and Its Variations, где представил LCS и кратчайший edit script как две стороны задачи о пути в edit graph. По одной оси графа располагается первая последовательность, по другой вторая. Горизонтальный шаг означает удаление, вертикальный вставку, а диагональный разрешён без стоимости, когда элементы совпадают.
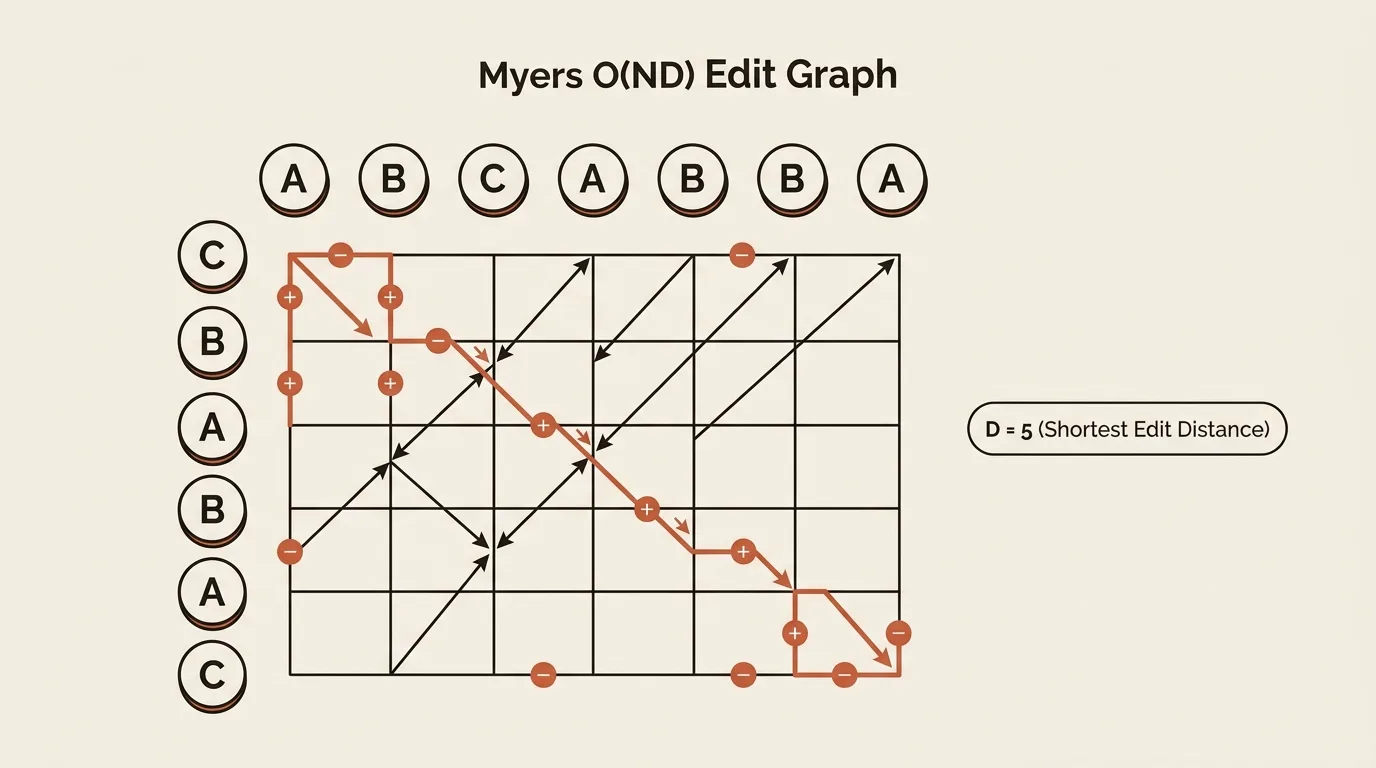
Алгоритм рассматривает пути с нулём изменений, затем с одним, двумя и так далее, пока один из них не достигнет конца обеих последовательностей. Для каждой диагонали достаточно хранить самую далёкую достигнутую позицию: путь, который пришёл туда раньше, не даст преимущества. После каждого изменения алгоритм проходит максимально длинную цепочку совпадений по диагонали, которую обычно называют snake.
В обозначениях статьи N является суммой длин двух последовательностей, а D соответствует длине минимального сценария из вставок и удалений. Основной алгоритм требует O(ND) времени, поэтому хорошо подходит для сравнения похожих файлов: при небольшом коммите D обычно намного меньше N. Майерс также описал вариант с линейной памятью и оценил ожидаемое время как O(N + D²) для принятой в статье вероятностной модели.
Кратчайший путь определяет минимальное число операций, но не всегда единственный способ их расположить. Если несколько строк одинаковы, выбор диагонального совпадения влияет на границы фрагментов и на то, какое изменение увидит читатель. Алгоритм может быть оптимальным по D и всё же выбрать менее понятное выравнивание.
Что на самом деле означает default diff в Git
В актуальной документации Git значения default и myers описаны как базовый greedy diff, который используется по умолчанию. Это связь с работой Майерса, а не утверждение, что Git хранит почти неизменный код 1986 года. Современная реализация находится в подсистеме xdiff, работает с подготовленными строками и участвует в более широком конвейере отображения изменений.
Даже при одном алгоритме итог зависит от дополнительных решений. Git определяет границы строк, может учитывать пользовательские diff drivers, выполняет собственное форматирование hunks и по умолчанию применяет indent heuristic, сдвигающую границы фрагментов к более читаемым местам. Поиск переименований, word diff и подсветка перемещённых строк находятся на других стадиях и не превращаются в свойства самого алгоритма Майерса.
Режим minimal остаётся близким к стандартному пути, но тратит дополнительное время, чтобы гарантировать наименьший возможный diff. Он полезен, когда размер сценария важнее скорости, однако меньше операций не обязательно означает более выразительное объяснение рефакторинга.
Patience и histogram меняют стратегию выравнивания
Patience diff начинает с общих строк, которые встречаются по одному разу с каждой стороны, и использует их как однозначные опорные точки. Затем промежутки между такими anchors сравниваются отдельно. В исходном коде это часто помогает не сопоставлять друг с другом повторяющиеся пустые строки, скобки или однотипные вызовы, поэтому переставленный блок выглядит цельнее.
У стратегии есть ограничение: уникальные строки присутствуют не в каждом фрагменте, а выбранные anchors не гарантируют глобально минимальный edit script. Режим стоит воспринимать как способ получить другое, часто более удобное для чтения выравнивание, а не как безусловно лучший алгоритм для рефакторингов.
Git описывает histogram как расширение patience, которое умеет опираться не только на уникальные, но и на редко встречающиеся общие элементы. Это даёт больше содержательных точек выравнивания в коде, где действительно уникальных строк мало. Результат по-прежнему зависит от конкретного файла, поэтому Git позволяет выбирать стратегию командой --diff-algorithm=myers|minimal|patience|histogram или настройкой diff.algorithm.
Сначала выбираются токены, затем строится diff
Алгоритм сравнивает не абстрактный текст, а последовательность токенов. Для обычного patch токеном служит строка, но тем же методом можно сопоставлять слова, символы, предложения или элементы массива. Изменение гранулярности меняет и N, и D, и смысл результата: построчный режим удобен для кода, пословный показывает правку фразы, а посимвольный помогает найти один знак в короткой строке.
После выравнивания результат ещё нужно представить. Unified diff с заголовками --- и +++ и фрагментами @@ является форматом вывода, а не отдельным алгоритмом поиска LCS. Одна и та же внутренняя последовательность изменений может быть показана единым patch, двумя колонками или цветными вставками внутри строки.
Как работает Text Diff
Text Diff загружает jsdiff 7.0.0 и сравнивает введённые данные в браузере; сами тексты на сервер не отправляются. Библиотека jsdiff основана на работе Майерса и сначала превращает текст в токены выбранного типа, после чего ищет минимальный набор однотокенных вставок и удалений.
В режиме Lines токенами становятся целые строки, а результат выводится единым цветным списком с номерами. Words и Chars показывают изменения внутри текста на уровне слов или символов. Статистика считает добавленные, удалённые и неизменившиеся единицы текущего режима, поэтому её числа означают строки только при выборе Lines. Два исходника расположены рядом во время ввода, но сам diff не является side-by-side таблицей.
Настройка Ignore whitespace тоже зависит от режима. Для Lines она передаётся в diffLines; для Words и Chars инструмент предварительно сворачивает последовательности пробелов и табуляций. Кнопка Copy unified diff всегда заново строит patch по полным исходным текстам через createTwoFilesPatch, независимо от экранного режима. Игнорирование пробелов влияет на копируемый patch только тогда, когда выбран Lines.
Скопированный результат содержит привычные заголовки ---, +++ и @@, но инструмент не пытается воспроизвести весь конвейер Git. У него нет repository context, diff drivers, определения переименований, indent heuristic, patience или histogram. Это локальное сравнение двух текстов, полезное для быстрого просмотра и получения обычного unified diff, а не браузерная реализация git diff со всеми его стадиями.
Похожие инструменты


Частые вопросы
Кто создал Unix diff?
Утилита diff появилась в Fifth Edition Unix в 1974 году. Её практический алгоритм описали Джеймс Хант и Дуглас Макилрой в техническом отчёте Bell Labs 1976 года. Он искал longest common subsequence строк, но ради производительности рассматривал только отобранные совпадения и использовал хеширование, сортировку в классы эквивалентности и двоичный поиск.
Что изменил алгоритм Майерса?
Юджин Майерс в 1986 году представил задачу как поиск кратчайшего пути в edit graph. Если N является суммарной длиной последовательностей, а D обозначает минимальное число вставок и удалений, основной алгоритм работает за O(ND). Поэтому он особенно эффективен для похожих файлов, где D намного меньше N.
Какой алгоритм git diff использует по умолчанию?
В актуальной документации Git режимы default и myers обозначают базовый greedy diff, который остаётся значением по умолчанию. Реальный вывод дополнительно зависит от настроек, разбиения текста и включённой по умолчанию indent heuristic, которая сдвигает границы фрагментов ради читаемости. Поэтому Git использует семейство идей Майерса, но не является неизменной копией статьи 1986 года.
Чем отличаются minimal, patience и histogram в Git?
Режим minimal тратит больше времени, чтобы получить наименьший diff. Patience ищет уникальные общие строки и использует их как устойчивые точки выравнивания, что часто помогает при перестановке блоков и повторяющемся синтаксисе. Histogram расширяет эту идею на общие строки с небольшой частотой. Ни один режим не даёт самый понятный результат для всех файлов.
Какие режимы есть в Text Diff?
Инструмент сравнивает строки, слова или символы через jsdiff 7.0.0, основанный на алгоритме Майерса. Экран показывает единый цветной поток изменений и статистику в единицах выбранного режима. Отдельная кнопка создаёт unified diff с заголовками ---, +++ и @@; это представление формируется по исходным текстам независимо от режима экранной подсветки.

Автор
Alex RelFullstack Engineer
В коммерческой разработке с 2011 года — больше 15 лет. Автор двух SaaS-продуктов: TeleGo.io и LingvoHabit.com. Статьи здесь выросли из реальной клиентской и продуктовой работы.