Откуда берутся кракозябры в кириллическом тексте
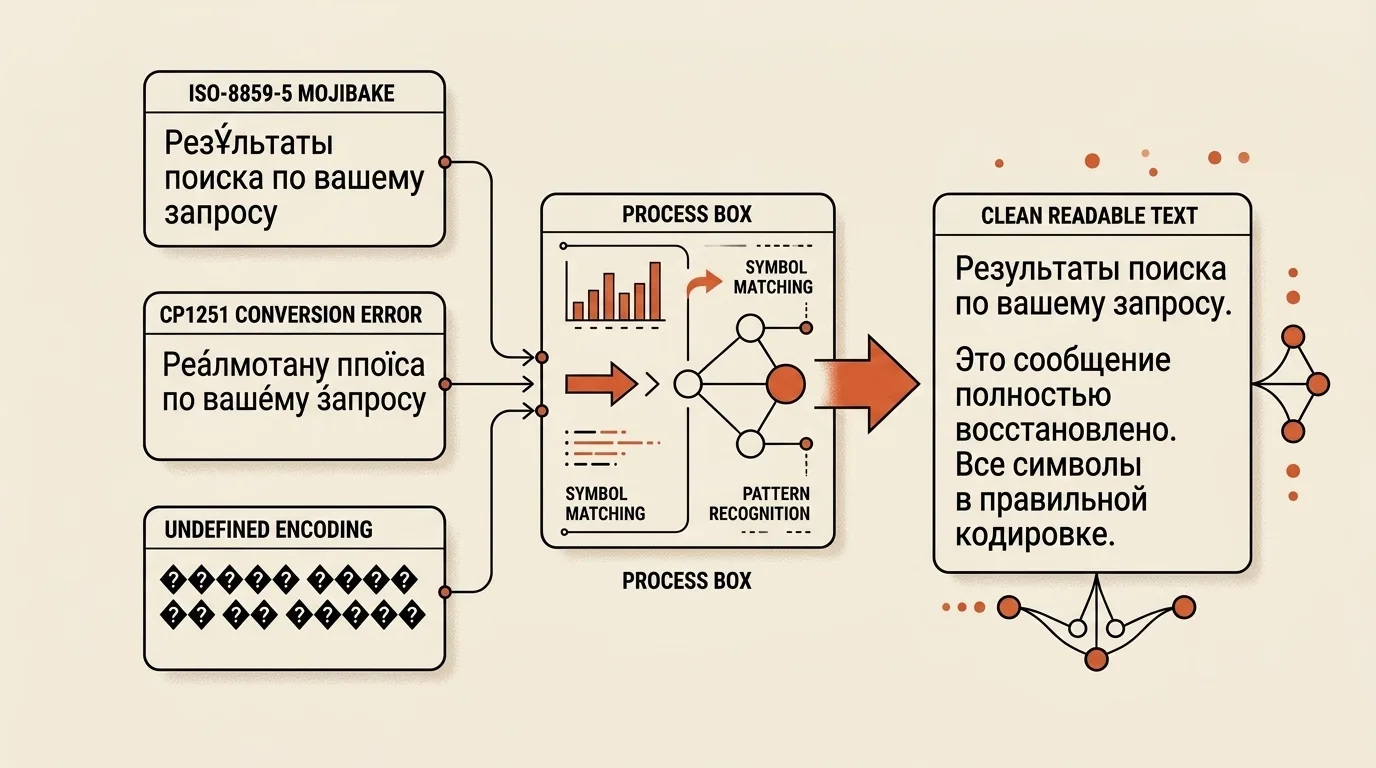
Если вы пользовались русскоязычным интернетом в 1990-х или начале 2000-х, то наверняка видели письмо, страницу или текстовый файл, в котором вместо слов появлялось что-то вроде Привет или ╨Я╤А╨╕╨▓╨╡╤В. Такие последовательности принято называть кракозябрами, а в международной технической литературе часто используют японское слово mojibake (文字化け).
Это не случайный набор символов и обычно не повреждение компьютера. Внутри по-прежнему лежат байты исходного сообщения, только программа прочитала их не по той таблице. Проблема стала особенно заметной на кириллице, потому что DOS, Unix, Windows и ранние сетевые сервисы долго использовали разные однобайтовые кодировки, а сведения о выбранной таблице могли потеряться при пересылке или быть указаны неверно.
Байты сами по себе не знают букв
Текстовый файл хранит не буквы, а числа. Кодировка задаёт соглашение о том, какой символ соответствует каждому числу или последовательности чисел. В старых однобайтовых наборах один байт обычно обозначал один символ, поэтому значение 0xCF, например, могло означать разные буквы в зависимости от выбранной таблицы. UTF-8 устроен иначе: символы за пределами ASCII записываются последовательностями из нескольких байтов.
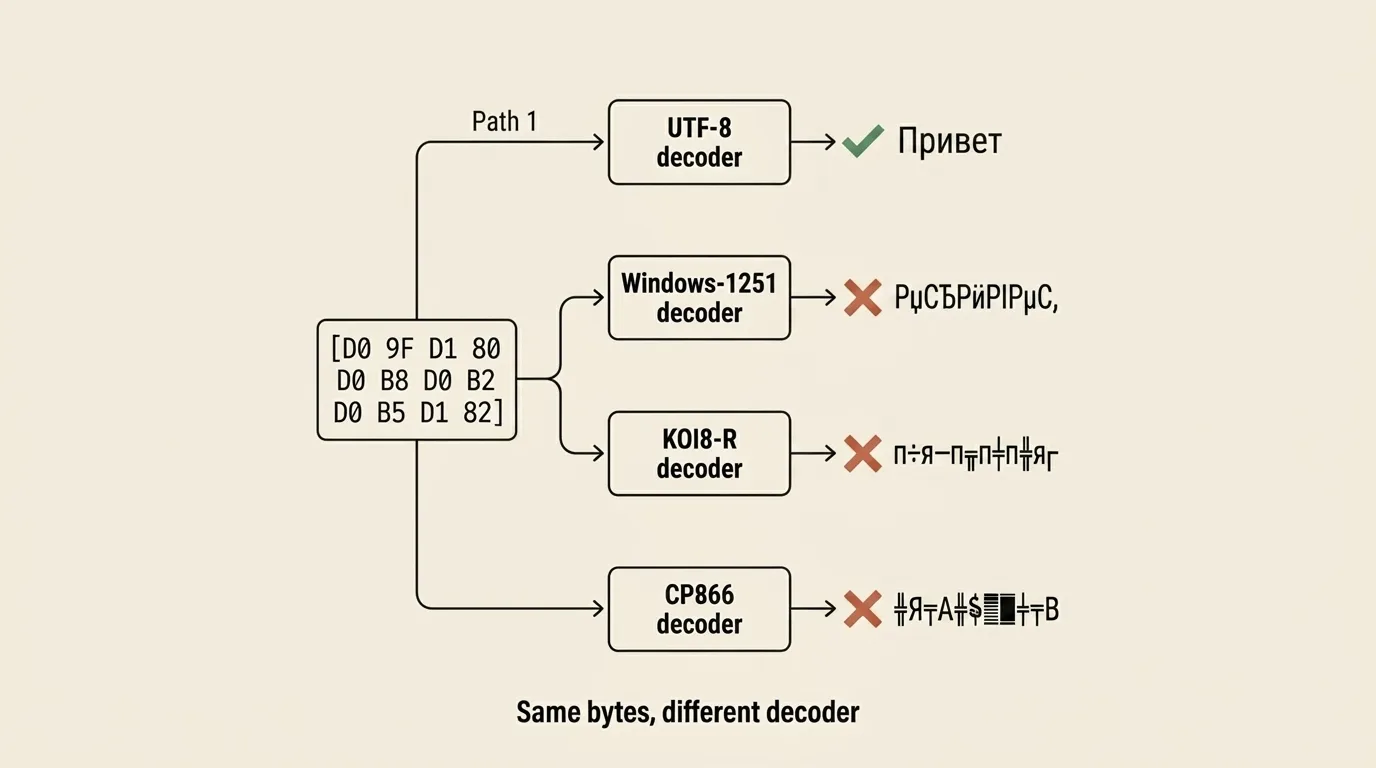
Русское слово Привет в UTF-8 начинается байтами D0 9F D1 80. Если отдать всю последовательность декодеру UTF-8, получится исходное слово. Если те же байты принять за Windows-1251, программа покажет Привет; при интерпретации как CP866 возникнет уже другая строка. Байты не изменились, изменилось только правило их чтения.
Отсюда следует важное ограничение: кракозябры можно исправить лишь до тех пор, пока ошибку удаётся обратить. Когда редактор заменил неизвестные знаки на ? или символ ``, отбросил часть байтов, выполнил нормализацию с потерями либо сохранил испорченный результат ещё несколько раз, восстановить недостающую информацию уже неоткуда.
От советского стандарта к KOI8-R
Одна из исторических линий начинается с ГОСТ 19768-74, принятого в СССР в 1974 году для обмена и обработки данных. Стандарт описывал наборы КОИ-7 и КОИ-8, а его ранняя восьмибитная таблица позднее стала одним из источников для сетевых кириллических кодировок. Современную KOI8-R нельзя считать простым переименованием того ГОСТа: в RFC 1489 прямо указано, что её таблица опиралась также на другие кириллические наборы.
RFC 1489 опубликовали в июле 1993 года как информационный документ, его автором был Андрей Чернов из Relcom Development Team. Документ не объявлял KOI8-R международным стандартом, а фиксировал уже сложившуюся практику большой пользовательской среды. К тому времени кодировка фактически использовалась в Unix-системах и сетевых приложениях на территории бывшего СССР, включая Relcom.
Главная запоминающаяся особенность KOI8-R связана с расположением русских букв. Нижняя половина таблицы совпадает с ASCII, а многие кириллические символы в верхней половине поставлены напротив приблизительно соответствующих латинских букв. Если старший бит каждого байта терялся в старой семибитной почтовой цепочке, фраза не сохранялась в нормальном виде, но иногда оставалась узнаваемой. Так, Код для обмена информацией после обнуления старшего бита превращается в kOD DLQ OBMENA INFORMACIEJ.
Этот результат легко принять за готовую транслитерацию, хотя на самом деле это лишь побочный эффект таблицы: регистр меняется, соответствия приблизительны, а знаки без подходящей ASCII-пары могут пропасть или исказиться. Свойство помогало понять знакомую фразу в некоторых аварийных ситуациях, но не гарантировало читаемость произвольного текста. Обратной стороной такого расположения был неалфавитный порядок кодов, из-за которого сортировка требовала знания самой кодировки.
CP866 для DOS и Windows-1251 для Windows
У DOS сложилась другая ветвь. Кодовая страница CP866 выросла из так называемой альтернативной кириллической кодировки и сохранила значительную часть псевдографики IBM PC: рамки, линии и углы, из которых текстовые программы собирали окна и таблицы. В 1990 году её включили в русскую версию MS-DOS 4.01, а в современной таблице идентификаторов Microsoft она проходит как OEM Russian, Cyrillic (DOS). Поэтому CP866 часто встречается в старых текстовых файлах, архивах, играх, терминальных интерфейсах и документах, созданных в DOS-программах.
С Windows распространилась ещё одна таблица. Кодовая страница Windows-1251 уже перечислена как Windows Cyrillic в документации Windows 3.1 1992 года, а затем широко использовалась приложениями Windows и русскоязычными сайтами. В ней основные блоки русских букв расположены близко к алфавитному порядку, а дополнительные кириллические буквы и знаки пунктуации занимают другие позиции таблицы.
Ситуацию того времени удобно кратко описывать как три большие среды: KOI8-R была характерна для Unix, электронной почты и ранних сетей, CP866 для DOS, а Windows-1251 для настольных приложений Windows и заметной части веба. Это полезная схема, но не полный список. Рядом существовали ISO-8859-5, Mac Cyrillic и локальные варианты, поэтому пользователь мог получить несовместимость даже тогда, когда обе программы формально поддерживали кириллицу.
Как появлялась «война кодировок»
Само разнообразие таблиц ещё не обязано портить текст. Проблема начинается, когда из цепочки исчезает информация о кодировке или одна из программ ей не доверяет. Почтовое сообщение могло прийти без корректного параметра charset, веб-сервер мог отправить один заголовок, а HTML-страница указать другой, редактор мог открыть старый файл в системной кодировке по умолчанию. Похожая ошибка возникала при импорте CSV, переносе базы данных или неверно настроенной кодировке соединения с СУБД.
Иногда неверно прочитанный текст затем сохраняли снова. После первого шага исходные байты UTF-8 превращались в видимые символы Windows-1251, а после второго эти символы уже кодировались как новая строка. Так появлялись многоступенчатые варианты mojibake, по внешнему виду которых можно примерно восстановить путь ошибки. Именно этот бытовой опыт и породил выражение «война кодировок»: разные платформы были логичны внутри своих границ, но обмен между ними постоянно обнаруживал несовместимость.
Unicode и постепенный переход на UTF-8
Первая версия стандарта Unicode вышла в октябре 1991 года и предложила другой подход: вместо отдельной ограниченной таблицы для каждого языка символ получает общий код. UTF-8 стал способом записывать эти коды в байты с сохранением совместимости с ASCII. Его спецификация развивалась вместе с Unicode и ISO/IEC 10646, а действующий формат для интернета закреплён, в частности, в RFC 3629 2003 года.
Однако наличие хорошего стандарта не означает мгновенного перехода. Требовалось обновить операционные системы, редакторы, базы данных, серверные настройки и содержимое уже существующих архивов. В течение 2000-х и 2010-х доля UTF-8 росла постепенно, при этом старые сайты и документы ещё долго оставались в Windows-1251, KOI8-R или CP866. По данным W3Techs, в августе 2026 года UTF-8 использовали 99% сайтов, для которых известна кодировка, но эта статистика ничего не меняет в байтах старого архива или резервной копии.
Поэтому кракозябры встречаются и сегодня. Обычно они приходят не из современного документа, который внезапно «сломался», а из старого файла, выгрузки прежней базы, неверного импорта CSV, ошибочного HTTP-заголовка или уже однажды неправильно пересохранённого текста.
Что именно делает String Transformer
String Transformer помогает исследовать такую строку прямо в браузере. Автоматическое восстановление перебирает распространённые пары видимой и предполагаемой исходной кодировки, среди которых UTF-8, Windows-1251, KOI8-R, CP866, ISO-8859-5 и Mac Cyrillic. Затем инструмент оценивает получившиеся строки и показывает до шести наиболее правдоподобных вариантов для кириллицы или иврита. Это эвристика, а не доказательство, поэтому окончательный вариант всё равно нужно сверить по смыслу.
В ручном режиме можно выбрать кодировку и выполнить преобразования, зависящие от байтов: URL encoding, Base32, Base45, Base64, hex, Ascii85, quoted-printable и byte escapes. Набор доступных legacy-кодировок зависит от поддержки TextDecoder в конкретном браузере, поэтому неподдерживаемые варианты интерфейс отключает. Все операции выполняются локально, введённый текст не отправляется на сервер.
Кроме работы с байтами, инструмент меняет регистр и стиль имён, исправляет текст, набранный в неправильной русской или английской раскладке, транслитерирует кириллицу и преобразует HTML entities, Unicode escapes, азбуку Морзе и Брайль. Исправление раскладки здесь важно не путать с восстановлением кодировки: в первом случае символы были набраны не теми клавишами, а во втором правильные байты прочитали по неверной таблице.
Для быстрой проверки можно вставить Привет и посмотреть предложенные варианты восстановления, а затем набрать ghbdtn и отдельно применить исправление раскладки. Если автоматический кандидат выглядит убедительно, сохраните результат в новом файле с явно указанной UTF-8, не перезаписывая единственную копию исходных данных.
Похожие инструменты


Частые вопросы
Что такое кракозябры (mojibake)?
Кракозябры появляются, когда последовательность байтов записали в одной кодировке, а прочитали по правилам другой. Сами данные при этом могут оставаться целыми, однако числам и их последовательностям назначаются не те символы. Японский термин mojibake (文字化け) обозначает именно такое искажённое отображение текста.
Какие кириллические кодировки использовались до UTF-8?
В русскоязычной среде особенно заметны были KOI8-R в Unix и ранних сетях, CP866 в DOS и Windows-1251 в настольных версиях Windows. Это упрощённая карта: рядом существовали ISO-8859-5, Mac Cyrillic и другие наборы, поэтому реальных вариантов несовместимости было больше трёх.
Почему текст в KOI8-R частично переживал потерю старшего бита?
Буквы в KOI8-R размещены так, что после обнуления старшего бита многие русские символы превращаются в приблизительно соответствующие латинские. Например, «Код для обмена информацией» становится «kOD DLQ OBMENA INFORMACIEJ». Это не обычная транслитерация и не гарантия читаемости любого текста, но знакомую фразу иногда всё ещё можно распознать.
Можно ли автоматически восстановить текст из битой кодировки?
Иногда можно. Восстановление работает, когда исходные байты не потеряны и ошибочное преобразование обратимо. Если программа уже заменила неизвестные символы знаками вопроса или U+FFFD, обрезала данные либо несколько раз пересохранила текст с потерями, полного исходника в испорченной строке больше нет.

Автор
Alex RelFullstack Engineer
В коммерческой разработке с 2011 года — больше 15 лет. Автор двух SaaS-продуктов: TeleGo.io и LingvoHabit.com. Статьи здесь выросли из реальной клиентской и продуктовой работы.