Как Markdown стал языком обычного текста для веба
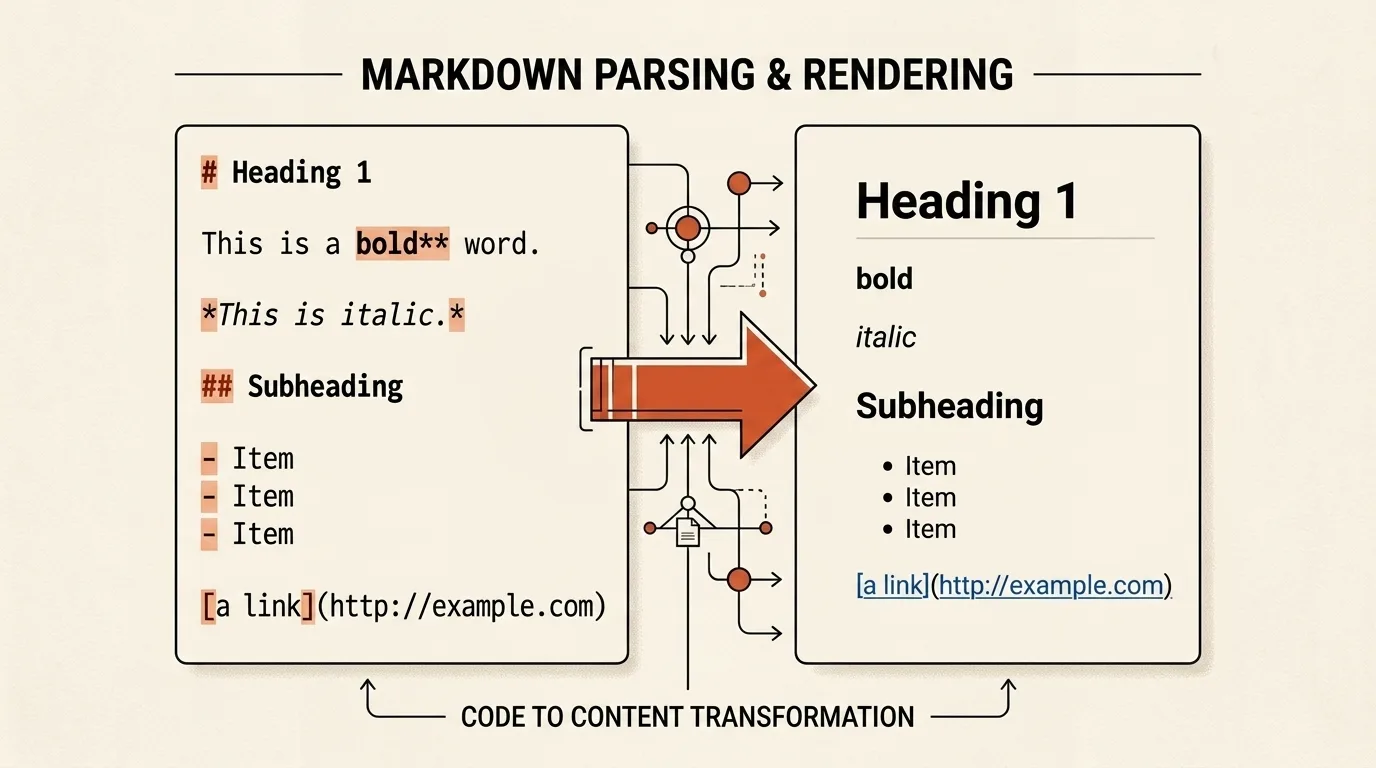
Markdown часто замечают только в тот момент, когда он срабатывает неправильно: список внезапно продолжается как обычный абзац, вложенный блок съезжает из-за отступа, а строка с решёткой оказывается не заголовком. В нормальном случае знаки разметки почти не мешают чтению, и именно это было главной целью формата. В 2004 году Markdown предлагал веб-авторам писать понятный исходный текст и поручать небольшому конвертеру превращение этого текста в HTML. Через два десятилетия тот же принцип оказался удобен для README, документации, заметок и интерфейсов, которые показывают ответы языковых моделей.
Сначала это были формат и Perl-скрипт
15 марта 2004 года Джон Грубер опубликовал на Daring Fireball заметку Introducing Markdown. Он представил Markdown как инструмент преобразования текста в HTML для веб-авторов, который мог работать плагином для Movable Type и Blosxom либо как отдельный Perl-скрипт. Важно, что одним именем назывались сразу две вещи: правила записи структурированного текста и программа Markdown.pl, выполнявшая преобразование.
Грубер не пытался заменить HTML новым универсальным языком. В документации синтаксиса он разделял роли прямо: HTML служит форматом публикации, а Markdown помогает писать и редактировать прозу. Если небольшой синтаксис Markdown не покрывал нужную конструкцию, автор мог вставить обычный HTML. Такой подход позволял оставить формат компактным и не переносить в него всю сложность веб-разметки.
Главным источником вдохновения Грубер называл оформление обычных текстовых писем. Символ > уже напоминал цитирование в email, звёздочки выглядели как выделение, а дефисы естественно читались как пункты списка. На синтаксис также повлияли существовавшие фильтры Setext, atx, Textile, reStructuredText, Grutatext и EtText. Поэтому Markdown возник не из одного внезапного изобретения, а из отбора знакомых текстовых соглашений, которые хорошо сохраняли смысл без визуального редактора.
Что именно сделал Аарон Шварц
Аарон Шварц участвовал в создании формата заметно больше, чем обычный пользователь бета-версии, но его вклад лучше описывать словами самих участников. На странице проекта Грубер благодарит Шварца за идеи, обратную связь и тестирование синтаксиса. Там же указан созданный Шварцем html2text, который решал обратную задачу и превращал HTML в читаемый текст, совместимый с Markdown.
До этой работы Шварц опубликовал собственный текстовый формат atx. Оригинальная документация Markdown перечисляет atx среди источников влияния и называет заголовки с одной или несколькими решётками ATX-style headings. Эта связь хорошо документирована, однако она не означает, что все правила заголовков были перенесены без изменений или что вклад Шварца ограничивался одним символом #. Точнее считать его участником проектирования и тестирования формата, тогда как код первого конвертера и публичный выпуск принадлежали Груберу.
После мартовской публикации Markdown продолжал меняться. Версия 1.0 вышла из бета-статуса 28 августа 2004 года, а 17 декабря Грубер выпустил Markdown 1.0.1, исправив ошибки и часть неоднозначных случаев. В тот же день проект перешёл с GPL на более разрешительную BSD-style лицензию, что упростило включение конвертера и его идей в другие программы.
Читаемый синтаксис не означает однозначный синтаксис
У Markdown была подробная справка по заголовкам, ссылкам, цитатам, спискам, выделению и коду, но не было строгой спецификации парсера. Для автора это долго не выглядело проблемой: **текст** легко распознавался как сильное выделение, # Заголовок как заголовок, а пустая строка отделяла абзацы. Сложности начинались, когда конструкции вкладывались друг в друга или несколько правил подходили к одной строке.
Сколько пробелов требуется перед вложенным списком? Может ли заголовок начинаться сразу после абзаца? Что важнее в неоднозначной строке, маркер списка, code span или ссылка? Документация не всегда отвечала на такие вопросы, а поведение Markdown.pl не во всём совпадало с текстовым описанием. Разработчики новых парсеров выбирали разные трактовки и добавляли расширения для таблиц, зачёркивания, footnotes и fenced code blocks. В результате название Markdown стало обозначать семейство похожих диалектов, а одинаковый файл мог рендериться по-разному в двух системах.
От Standard Markdown к CommonMark
В 2014 году группа разработчиков парсеров и крупных платформ начала формализовать совместимое ядро языка. Среди участников были автор Pandoc Джон Макфарлейн, Джефф Этвуд, а также представители GitHub, Reddit, Stack Overflow и Meteor. Сначала проект получил название Standard Markdown, однако Грубер попросил не использовать слово Markdown в имени, которое могло создавать впечатление единственного официального стандарта. В сентябре 2014 года проект переименовали в CommonMark.
CommonMark не просто переписал старую справку более строгими словами. Его спецификация содержит сотни пар Markdown и HTML, которые одновременно объясняют правило и проверяют поведение реализации. Она определяет приоритет блоковых и строчных конструкций, обработку пробелов, границы списков, ссылок, code spans и других спорных участков. Текущая опубликованная версия имеет номер 0.31.2, поэтому CommonMark формально не дошёл до 1.0, но его правила уже служат практической основой для многих парсеров.
GitHub использует не чистый CommonMark, а GitHub Flavored Markdown. Спецификация GFM называет его строгим надмножеством CommonMark и отдельно описывает расширения для таблиц, task lists, зачёркивания и дополнительных autolinks. Это хороший пример современного устройства экосистемы: CommonMark задаёт совместимое ядро, а конкретная платформа добавляет функции, необходимые её интерфейсу.
Почему формат пережил среду, для которой создавался
Markdown оказался долговечным не потому, что одна версия победила все остальные. Его преимущество сохранилось даже среди диалектов: структура остаётся видимой в исходном тексте, файл можно открыть обычным редактором, а преобразование не требует закрытого двоичного формата. Эти свойства удобны для контроля версий, технической документации, статических генераторов сайтов и приложений, которые хранят заметки в текстовых файлах.
Похожая причина объясняет появление Markdown в AI-интерфейсах. Многие чат-клиенты умеют превращать заголовки, списки, ссылки и блоки кода в оформленный ответ, но исходная последовательность символов остаётся понятной и без такого рендеринга. При этом нельзя утверждать, что каждая языковая модель использует Markdown как внутренний формат или всегда обязана ему следовать. Модель создаёт текст, а конкретное приложение решает, какие конструкции распознать, разрешить и безопасно показать.
Что умеет наш редактор
Markdown Editor работает целиком в браузере и показывает редактор рядом с живым предпросмотром. Панель добавляет заголовки, выделение, ссылки, изображения, списки, цитаты, task lists, code blocks и таблицы; доступны undo и redo, счётчики слов и символов, синхронизация прокрутки, просмотр HTML с номерами строк, копирование HTML и выгрузка файлов .md или .html.
Для преобразования используется библиотека Marked с включёнными опциями GFM и breaks. Поэтому инструмент понимает таблицы, task lists, зачёркивание и fenced code blocks, а одиночные переводы строк отображает как разрывы строк. Это поведение удобно для интерактивного редактора, но не обязано полностью совпадать с другим Markdown-парсером.
Есть два важных ограничения. Редактор не сохраняет документ между перезагрузками страницы, поэтому результат нужно скачать или скопировать до закрытия вкладки. Кроме того, Marked не очищает сгенерированный HTML от потенциально опасных конструкций, и наш предпросмотр не добавляет отдельный sanitizer. Используйте редактор для собственного или доверенного текста и не вставляйте полученный из неизвестного источника Markdown как безопасный HTML на другой сайт. Само преобразование выполняется локально, хотя внешние изображения и другие ресурсы в предпросмотре могут загружаться браузером с указанных адресов.
Похожие инструменты


Частые вопросы
Кто создал Markdown?
Джон Грубер написал первый конвертер Markdown.pl, сформулировал цели формата и выпустил его на Daring Fireball в 2004 году. Аарон Шварц участвовал в обсуждении синтаксиса, предлагал идеи, тестировал Markdown и написал обратный конвертер html2text. Поэтому точнее говорить, что Грубер создал и реализовал Markdown при существенном участии Шварца.
Почему Markdown стал популярным?
Markdown оставляет исходный текст понятным без предварительного рендеринга, но при этом позволяет превратить его в структурированный HTML. Формат было легко встроить в блоги, репозитории, форумы и генераторы документации, а свободная лицензия исходного конвертера упростила появление новых реализаций. Популярность привела не к одному универсальному Markdown, а к нескольким совместимым диалектам.
Чем CommonMark отличается от оригинального Markdown?
Оригинальная документация Markdown описывала основные конструкции, но не давала однозначного ответа для многих сочетаний списков, отступов, ссылок и блоков. CommonMark превратил эти пограничные случаи в подробные правила и сотни примеров, которые одновременно служат тестами совместимости. GitHub Flavored Markdown строится поверх CommonMark и добавляет собственные расширения, включая таблицы и task lists.
Почему ответы AI часто выглядят как Markdown?
Многие чат-интерфейсы распознают Markdown-подобные заголовки, списки, ссылки и блоки кода, поскольку эти конструкции остаются понятными даже в сыром текстовом ответе. Модель при этом выдаёт последовательность текста, а решение о рендеринге принимает клиентское приложение. Поэтому Markdown удобен для AI-интерфейсов, но не является обязательным форматом каждой модели или каждого ответа.

Автор
Alex RelFullstack Engineer
В коммерческой разработке с 2011 года — больше 15 лет. Автор двух SaaS-продуктов: TeleGo.io и LingvoHabit.com. Статьи здесь выросли из реальной клиентской и продуктовой работы.